Le mot est mal choisi et tout le monde le sait. « Hallucination » suggère un accident, un dysfonctionnement passager, quelque chose qu'un correctif viendra régler. La réalité mesurée est plus embarrassante : un modèle de langage produit la suite de mots la plus probable, et lorsqu'il ne dispose pas de l'information, la suite la plus probable est une affirmation plausible et fausse. Ce n'est pas une panne, c'est le régime nominal.
Ce que l'on peut mesurer, en revanche, c'est la fréquence. Plusieurs organisations le font publiquement, avec des méthodes documentées. Le problème est qu'elles n'obtiennent pas les mêmes chiffres, et que l'écart ne vient pas des modèles mais des tests. Cette enquête a repris chaque classement à sa source pour comprendre ce que ces pourcentages décrivent — et pour établir ce qui, en contexte professionnel, marche vraiment quand il faut vérifier.
L'enquête en 30 secondes
Que mesure-t-on quand on parle d'un taux d'hallucination ?
Deux familles de mesures cohabitent sous le même mot, et elles n'ont presque rien en commun.
La première mesure la fidélité à un document fourni. On donne un texte au modèle, on lui demande de le résumer ou d'y répondre, et on compte les affirmations que le document ne soutient pas. C'est ce que fait le classement de Vectara avec son modèle d'évaluation HHEM, et c'est ce que mesure le volet Grounding de la suite FACTS de Google DeepMind. Cette famille correspond à l'usage professionnel dominant : faire travailler une IA sur des documents que l'on possède.
La seconde mesure l'exactitude sans document, c'est-à-dire ce que le modèle sait de mémoire. C'est l'objet de SimpleQA, publié par OpenAI, un jeu de 4 326 questions factuelles courtes dont la réponse est vérifiable et non ambiguë.
Confondre les deux produit les absurdités que l'on lit partout. Un modèle qui affiche 3 % d'infidélité en résumé peut se tromper sur plus de la moitié des questions factuelles posées à froid. Ce ne sont pas deux évaluations du même objet : ce sont deux compétences distinctes, et un même chiffre ne peut pas décrire les deux.
Que disent les classements publics, et pourquoi divergent-ils ?
Le 19 novembre 2025, Vectara a publié une nouvelle génération de son classement d'hallucination. L'ancien reposait sur un millier d'articles courts ; le nouveau en compte plus de 7 700, allant jusqu'à 32 000 tokens, répartis entre technologie, médecine, droit et finance, dont 3 939 classés comme documents à forte complexité. La tâche reste la même — résumer fidèlement — et l'évaluateur automatique aussi.
Les résultats sont sévères. Gemini 2.5 Flash Lite affiche 3,3 % d'hallucination, Gemini 3 Pro 13,6 %, tandis que Claude Sonnet 4.5 et GPT-5 dépassent tous deux les 10 %. Sur l'ancien corpus, la famille GPT se situait entre 0,8 % et 2 %, et même les plus mauvais élèves restaient sous les 15 %.
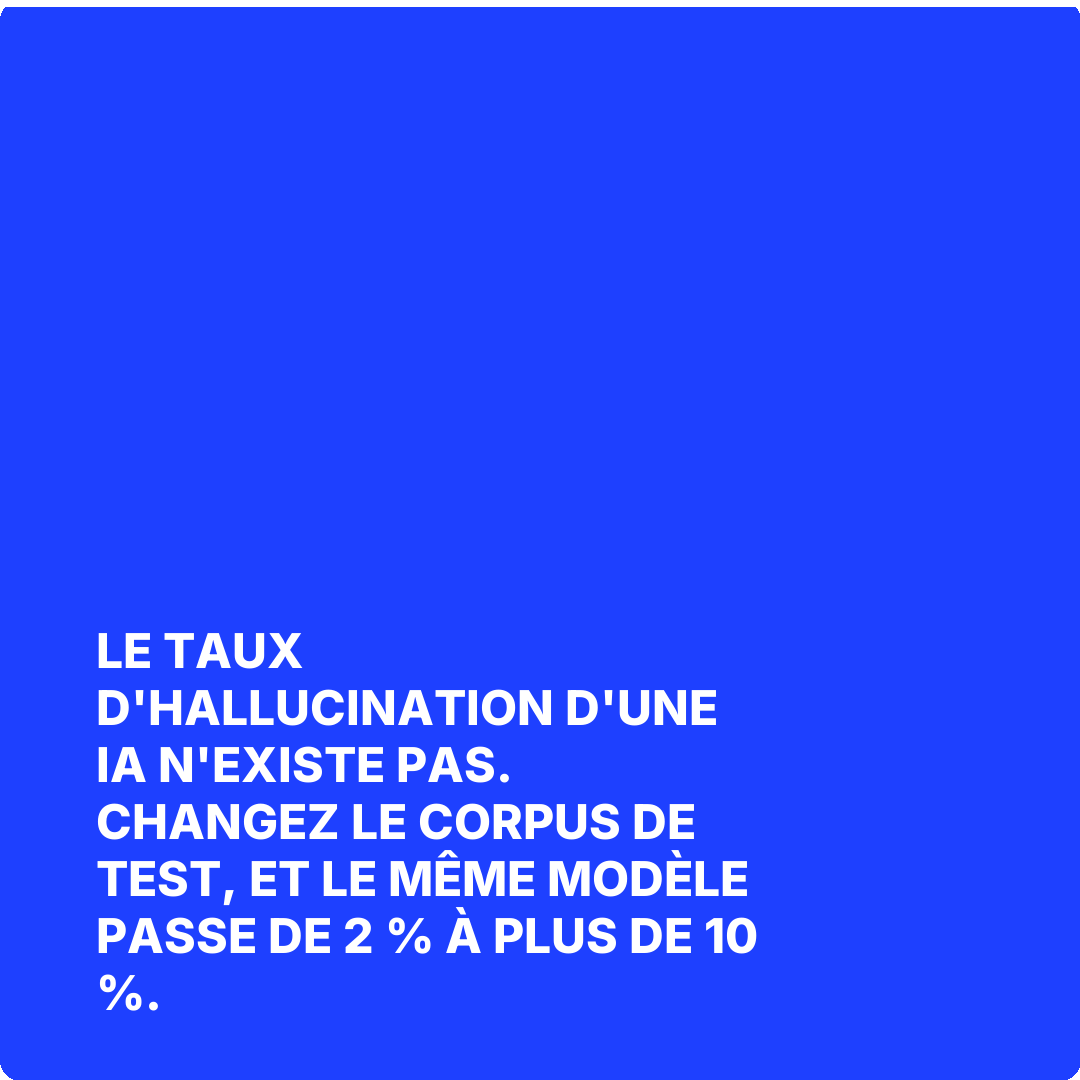
Voilà la contradiction qu'il faut publier telle quelle : le même évaluateur, appliqué à la même tâche, multiplie par cinq ou davantage le taux d'un modèle selon la difficulté du corpus. Le taux d'hallucination n'est pas une propriété du modèle. C'est une propriété du couple modèle-corpus. Tout chiffre cité sans son jeu de test ne veut rien dire, y compris — et surtout — celui qui figure dans une plaquette.
La suite FACTS de Google DeepMind, publiée le 9 décembre 2025, va dans le même sens par un autre chemin. Elle rassemble quatre épreuves — connaissance paramétrique, recherche, multimodal, ancrage documentaire — pour 3 513 exemples rendus publics, doublés d'un jeu privé pour limiter la contamination. Le meilleur modèle évalué, Gemini 3 Pro, obtient un score global de 68,8 %. Les auteurs le formulent sans détour : tous les modèles évalués restent sous 70 % d'exactitude.
Sur SimpleQA enfin, le modèle o1-preview d'OpenAI répondait correctement à 42,7 % des questions, et Claude 3.5 Sonnet à 28,9 %. Ces scores sont ceux de 2024 et les modèles ont progressé depuis ; ils rappellent néanmoins l'ordre de grandeur du problème quand on interroge un modèle sans lui fournir de source.
Taux d'hallucination en résumé : le même évaluateur, deux corpus, des chiffres incomparables
Pourquoi un modèle préfère-t-il inventer plutôt que se taire ?
La réponse la plus solide vient d'OpenAI, ce qui ne manque pas d'intérêt. Le 4 septembre 2025, Adam Tauman Kalai, Ofir Nachum, Santosh Vempala et Edwin Zhang publient Why Language Models Hallucinate. Leur thèse tient en une phrase : les procédures d'entraînement et surtout d'évaluation récompensent la devinette plutôt que l'aveu d'ignorance.
Le mécanisme est celui d'un examen à choix multiples sans points négatifs. Quand un modèle est noté sur le pourcentage de réponses exactes, répondre « je ne sais pas » rapporte zéro, tandis que deviner rapporte l'espérance mathématique du hasard. Un modèle optimisé sur ces critères apprend rationnellement à toujours répondre. Les auteurs notent que la majorité des évaluations de référence du secteur récompensent ce comportement, et proposent une réforme des barèmes plutôt qu'une réforme des modèles.
Un second travail complète le tableau et il est plus dérangeant encore pour l'usage en entreprise. L'étude Sufficient Context, présentée à la conférence ICLR 2025 par Hailey Joren et ses coauteurs, mesure ce qui se passe quand on fournit au modèle un contexte qui ne contient pas la réponse. Le modèle Gemma répond faux dans 10,2 % des cas sans aucun contexte, et jusqu'à 66,1 % avec un contexte insuffisant. Les grands modèles propriétaires — Gemini, GPT, Claude — excellent quand le contexte suffit, mais préfèrent produire une réponse fausse plutôt que s'abstenir lorsqu'il ne suffit pas.
Conséquence directe pour tout dispositif professionnel : brancher une IA sur une base documentaire mal tenue est pire que ne pas la brancher du tout.
Que se passe-t-il quand personne ne vérifie ?
Le droit fournit le corpus d'incidents le mieux documenté du monde, pour une raison mécanique : une décision de justice est publique, datée, et elle nomme les faits.
Le point de départ est l'affaire Mata v. Avianca, tranchée le 22 juin 2023 par le tribunal fédéral du district sud de New York. Deux avocats avaient déposé un mémoire citant six décisions entièrement inventées par ChatGPT. Sanction : 5 000 dollars.
Depuis, Damien Charlotin, chercheur à HEC Paris, tient une base publique des décisions dans lesquelles une juridiction a constaté — explicitement ou implicitement — qu'une partie s'était appuyée sur du contenu halluciné. Le compteur atteignait 1 598 cas au 9 juin 2026 et 1 668 en juillet 2026. Détail qui déplace le procès en incompétence souvent fait aux justiciables : en juillet 2026, 975 cas concernaient des personnes non représentées, mais 653 concernaient des avocats en exercice. Les sanctions ont monté, jusqu'à environ 109 700 dollars cumulés dans une affaire de l'Oregon où quinze citations fausses et huit citations fabriquées avaient été déposées dans trois écritures.
La France a été rattrapée fin 2025. Le tribunal administratif de Grenoble relève le phénomène le 3 décembre 2025 puis le 9 décembre 2025 — dans le second cas, le requérant avait laissé son échange avec l'IA dans la pièce déposée. Le 29 décembre 2025, le tribunal administratif d'Orléans adresse la première mise en garde explicite à un avocat, après avoir identifié une quinzaine de références jurisprudentielles entièrement fausses, en employant dans sa décision les termes techniques d'hallucination et de confabulation. La cour administrative d'appel de Bordeaux suit le 26 février 2026. Huit décisions françaises ont mentionné le phénomène en trois mois. À la connaissance de cette enquête, aucune sanction disciplinaire n'a été prononcée à ce jour.
La règle que dégagent ces décisions est simple et transposable à toute profession : ce n'est pas l'usage de l'outil qui est sanctionné, c'est le défaut de vérification.
Ce que coûte l'absence de vérification, en décisions de justice
0
Décisions de justice mondiales liées à des contenus hallucinés recensées en juillet 2026, contre 1 598 le 9 juin
0
Parmi elles, celles impliquant un avocat en exercice et non un justiciable sans conseil
0
Références jurisprudentielles entièrement fausses relevées dans une seule écriture par le tribunal administratif d'Orléans
$0
Amende infligée dans Mata v. Avianca en juin 2023, première sanction du genre
Quelles méthodes de vérification tiennent réellement la mesure ?
Quatre approches sont documentées publiquement. Elles ne se remplacent pas et aucune ne suffit seule.
L'ancrage documentaire avec citation au fragment. C'est la base : le modèle ne répond qu'à partir d'extraits fournis, et chaque affirmation renvoie à l'extrait qui la porte, consultable en un clic. L'évaluation de Stanford sur les outils juridiques rappelle la limite : elle compte non seulement les faits inventés, mais aussi les citations qui existent et ne soutiennent pas ce qu'on leur fait dire. Une source affichée n'est pas une source vérifiée.
L'abstention explicite. C'est la traduction opérationnelle du travail de Kalai et ses coauteurs. Si le barème interne — celui de l'équipe, pas celui du modèle — valorise la réponse « l'information ne figure pas dans les documents fournis » autant qu'une bonne réponse, le comportement change. Si l'on note l'assistant sur son taux de réponse, on obtient mécaniquement de la devinette.
L'échantillonnage multiple et l'entropie sémantique. Sebastian Farquhar, Jannik Kossen, Lorenz Kuhn et Yarin Gal ont publié dans Nature en 2024 une méthode de détection des confabulations : on demande plusieurs fois la même chose, on regroupe les réponses par sens plutôt que par formulation, et l'on mesure la dispersion des significations. Une forte entropie sémantique signale une réponse arbitraire. Le principe est robuste, sa version artisanale — reposer la question autrement et comparer — est à la portée de n'importe quel professionnel. Son coût aussi est réel : générer cinq réponses coûte cinq fois plus cher qu'une seule.
La relecture humaine responsable. C'est la seule méthode que le droit européen reconnaît explicitement, et nous y venons.
Les vérificateurs automatiques sont-ils fiables ?
C'est la question que le marché évite, parce que la réponse commerciale évidente à l'hallucination consiste à faire vérifier un modèle par un autre modèle.
Les travaux d'évaluation systématique de ces « juges » automatiques publiés en 2026 donnent des ordres de grandeur qu'il faut connaître : à température standard, la cohérence d'un juge avec lui-même atteint environ 86 %, mais l'accord entre deux juges différents tombe à 76 %. Autrement dit, un juge automatique est raisonnablement reproductible, mais le choix du juge change le verdict dans près d'un cas sur quatre. Une littérature convergente documente par ailleurs un biais d'auto-préférence : un modèle reconnaît ses propres productions et les note mieux.
La conclusion opérationnelle n'est pas qu'il faut renoncer aux vérificateurs automatiques — ils passent à l'échelle, ce que l'humain ne fait pas. Elle est qu'un juge automatique déplace le problème sans le supprimer, et qu'il ne doit jamais être l'unique filtre avant une décision engageante.
Qu'impose désormais le droit européen ?
Depuis le 2 août 2026, les obligations de transparence du règlement européen sur l'intelligence artificielle sont applicables. Trois points concernent directement toute entreprise qui met de l'IA générative au contact de clients ou du public.
Un système conversationnel doit informer clairement l'utilisateur qu'il s'adresse à une machine. Les contenus générés ou modifiés par IA — images, sons, vidéos, textes — doivent être identifiés, par un marquage visible et par un marquage technique.
L'exception mérite d'être lue attentivement, car elle décrit exactement le processus de vérification que cette enquête décrit : l'obligation de divulgation pour les textes portant sur des sujets d'intérêt public tombe lorsque le contenu a fait l'objet d'une relecture éditoriale humaine substantielle et qu'une personne en assume la responsabilité. Le droit européen ne dit pas que l'IA est interdite ; il dit que quelqu'un doit répondre du texte.
Les manquements aux obligations de transparence peuvent être sanctionnés jusqu'à 15 millions d'euros ou 3 % du chiffre d'affaires mondial annuel. Une période transitoire court jusqu'au 2 décembre 2026 pour le marquage des systèmes déjà sur le marché. Les règles les plus lourdes, celles des systèmes à haut risque, ont été reportées à 2027 et 2028.
Trois ans de mesure de l'hallucination, du fait divers judiciaire à l'obligation légale
La première sanction
Dans Mata v. Avianca, le tribunal fédéral du district sud de New York sanctionne de 5 000 dollars deux avocats ayant déposé un mémoire citant six décisions entièrement inventées par ChatGPT. L'affaire devient la référence mondiale du risque.
Ce que cette enquête n'a pas pu établir
Quatre limites, dites franchement.
Aucun taux d'hallucination n'est transposable à un usage particulier. Les chiffres cités portent sur des tâches de résumé, de questions-réponses courtes ou de recherche juridique, sur des corpus construits pour être difficiles. Le taux d'un assistant interne sur des procédures d'entreprise ne peut être obtenu qu'en le mesurant sur ces procédures-là, avec un jeu de questions à réponse connue.
Les classements publics sont produits par des parties intéressées. Vectara vend des services de recherche augmentée, Google DeepMind conçoit les modèles qui figurent en tête de sa propre suite FACTS, OpenAI publie à la fois le benchmark SimpleQA et l'article expliquant pourquoi les modèles hallucinent. Les méthodes sont documentées et les jeux de données partiellement ouverts, ce qui vaut mieux que rien ; cela ne fait pas de ces classements des mesures indépendantes.
Les évaluateurs automatiques sont eux-mêmes des modèles. Les taux de Vectara sont produits par HHEM, un modèle d'évaluation. Ceux de la suite FACTS reposent sur des juges automatiques. Les chiffres d'accord entre juges cités plus haut — 76 % entre deux juges différents — s'appliquent aussi, en partie, aux instruments qui produisent les classements que l'on commente.
La base de décisions judiciaires sous-estime nécessairement le phénomène. Elle ne recense que les cas où une juridiction a explicitement constaté le recours à du contenu halluciné. Toutes les fausses citations qui n'ont pas été repérées, tous les documents professionnels erronés qui n'ont jamais atteint un tribunal, restent invisibles. Le compteur mesure les détections, pas les occurrences.
FAQ
Quel est le taux d'hallucination d'un modèle comme GPT ou Gemini ?
La question n'a pas de réponse unique, et c'est le point central. Sur le corpus historique de Vectara, la famille GPT se situait entre 0,8 % et 2 % d'infidélité en résumé ; sur le corpus renouvelé le 19 novembre 2025, composé de documents plus longs et plus complexes, GPT-5 et Claude Sonnet 4.5 dépassent 10 %, et Gemini 3 Pro atteint 13,6 %. Le taux dépend du corpus autant que du modèle.
Le RAG ou l'accès à une base documentaire règle-t-il le problème ?
Il le réduit sans le supprimer, et il peut l'aggraver. L'étude Sufficient Context présentée à ICLR 2025 mesure qu'un modèle testé passe de 10,2 % de réponses fausses sans contexte à 66,1 % avec un contexte insuffisant. Fournir de mauvais extraits est donc pire que n'en fournir aucun : la qualité de la base documentaire décide du résultat plus que le choix du modèle.
Comment vérifier concrètement une réponse en contexte professionnel ?
En trois gestes cumulatifs : exiger que chaque affirmation renvoie à un extrait consultable, et l'ouvrir plutôt que se fier à son existence ; reposer la même question autrement et comparer le sens des réponses, principe de l'entropie sémantique publiée dans Nature en 2024 ; réserver la relecture humaine complète aux documents engageants. Faire vérifier une IA par une autre IA ne suffit pas : deux juges automatiques divergent dans environ un quart des cas.
Que risque une entreprise qui publie du contenu généré sans le signaler ?
Depuis le 2 août 2026, le règlement européen sur l'IA impose d'informer l'utilisateur qu'il interagit avec une machine et de marquer les contenus générés. Les manquements aux obligations de transparence peuvent être sanctionnés jusqu'à 15 millions d'euros ou 3 % du chiffre d'affaires mondial annuel. Pour les textes d'intérêt public, l'obligation de divulgation tombe si une relecture éditoriale humaine substantielle a eu lieu et qu'une personne en assume la responsabilité.
L'enquête en slides